
فاکتور (Invoice)
شماره، تاریخ، تأمینکننده، خریدار، مبلغ کل، مالیات، اقلام سطری.

ابزارهای عملی برای خواندن، فهمیدن، استخراج، جستجو و سازماندهی مدارک سازمانی
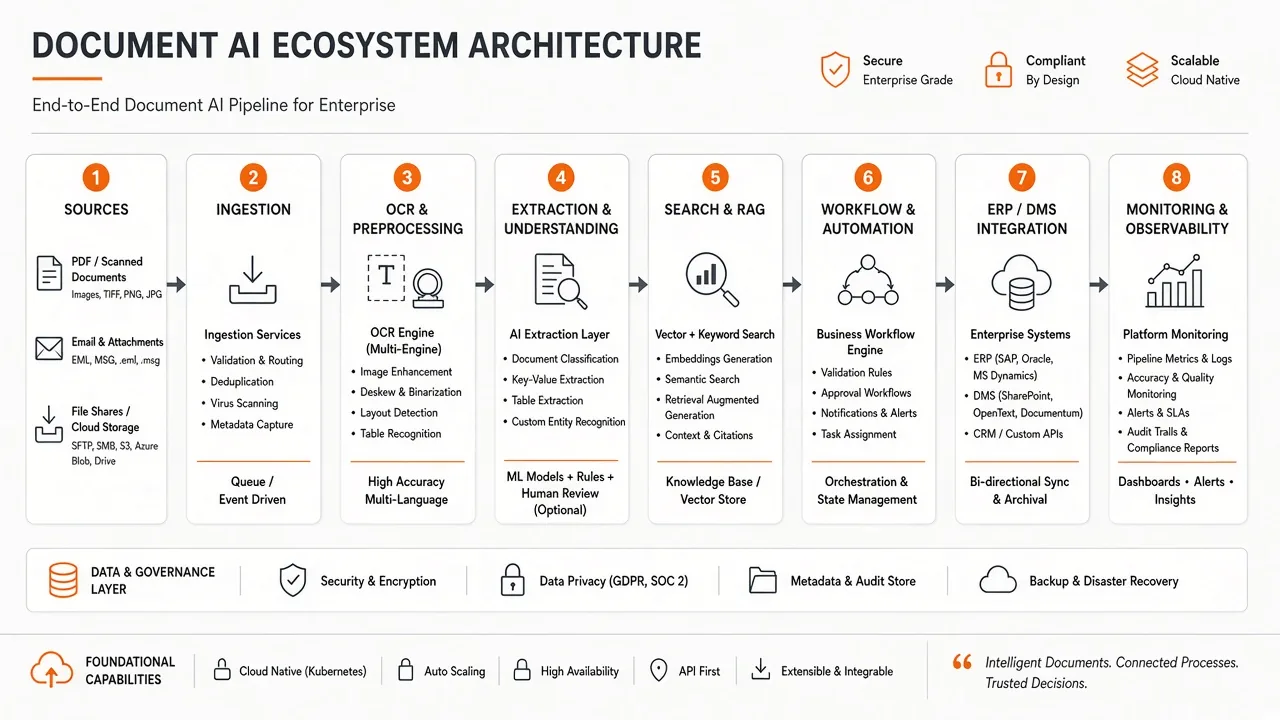
هوش مصنوعی مدیریت اسناد به استفاده از OCR، درک سند (Document Understanding)، یادگیری ماشین، مدلهای زبانی و فناوریهای بازیابی برای تبدیل اسناد غیرساختاریافته به اطلاعات قابل جستجو، ساختیافته و قابل اقدام گفته میشود. مسیر معمول: سند → OCR → درک → استخراج → طبقهبندی → اعتبارسنجی → ایندکس → جستجوی معنایی → RAG → گردشکار.
تمرکز این صفحه روی Document AI / IDP است — نه ساخت محصول عمومی AI، نه داشبورد تحلیلی و نه اتوماسیون فرآیندهای غیرسندی. مرز صفحات: توسعه نرمافزار هوش مصنوعی، تحلیل داده با AI، اتوماسیون عملیات سازمانی، هوش مصنوعی منابع انسانی، و RAG و دستیار سازمانی.
| قابلیت | چه میکند | مثال | ارزش کسبوکار |
|---|---|---|---|
| OCR | تبدیل تصویر/اسکن به متن | PDF اسکنشده فاکتور | متن قابل جستجو |
| درک سند | شناخت ساختار و نوع محتوا | تشخیص بخشهای قرارداد | استخراج دقیقتر |
| استخراج اطلاعات | فیلدها و موجودیتها | تاریخ، مبلغ، طرفین | کاهش ورود دستی |
| استخراج جدول | ردیف/ستون به داده ساختیافته | اقلام فاکتور | آماده ERP |
| طبقهبندی | نوع سند | قرارداد / نامه / فرم | بایگانی خودکار |
| متادیتا | برچسب و ویژگیهای سند | واحد، پرونده، تاریخ | حاکمیت داده |
| اعتبارسنجی | بررسی قواعد و کاملبودن | مبلغ کل ≠ جمع اقلام | کاهش خطای ثبت |
| کمبود مدرک | تشخیص سند ناقص پرونده | بیمه / استخدام | تسریع بررسی |
| جستجوی معنایی | بازیابی مفهومی | پرسش به زبان طبیعی | زمان کمتر برای یافتن |
| پرسش روی سند | پاسخ grounded | مهلت تمدید قرارداد | دسترسی به دانش |
| خلاصهسازی | خلاصه کنترلشده | خلاصه قرارداد بلند | تصمیم سریعتر |
| مقایسه اسناد | تفاوت نسخهها (ماژول اختیاری) | نسخه قدیم/جدید آییننامه | کنترل تغییر |
| ایندکس | آمادهسازی برای جستجو | چانک + متادیتا | بازیابی پایدار |
| گردشکار | اتصال به فرآیند | تایید → ERP | عملیاتی شدن |
| بازبینی انسانی | Human-in-the-loop | قرارداد حساس | کنترل ریسک |
| Audit Log | ثبت دسترسی و عملیات | چه کسی چه سندی دید | پاسخگویی |
محدودیت مهم: کیفیت خروجی به کیفیت ورودی، تنوع layout و تعریف دامنه بستگی دارد؛ دقت ۱۰۰٪ ادعا نمیشود.
اگر حجم مدارک بالاست و اطلاعات داخل PDF گیر کرده، از یک نوع سند پرتکرار شروع کنید.
درخواست مشاوره مدیریت اسناد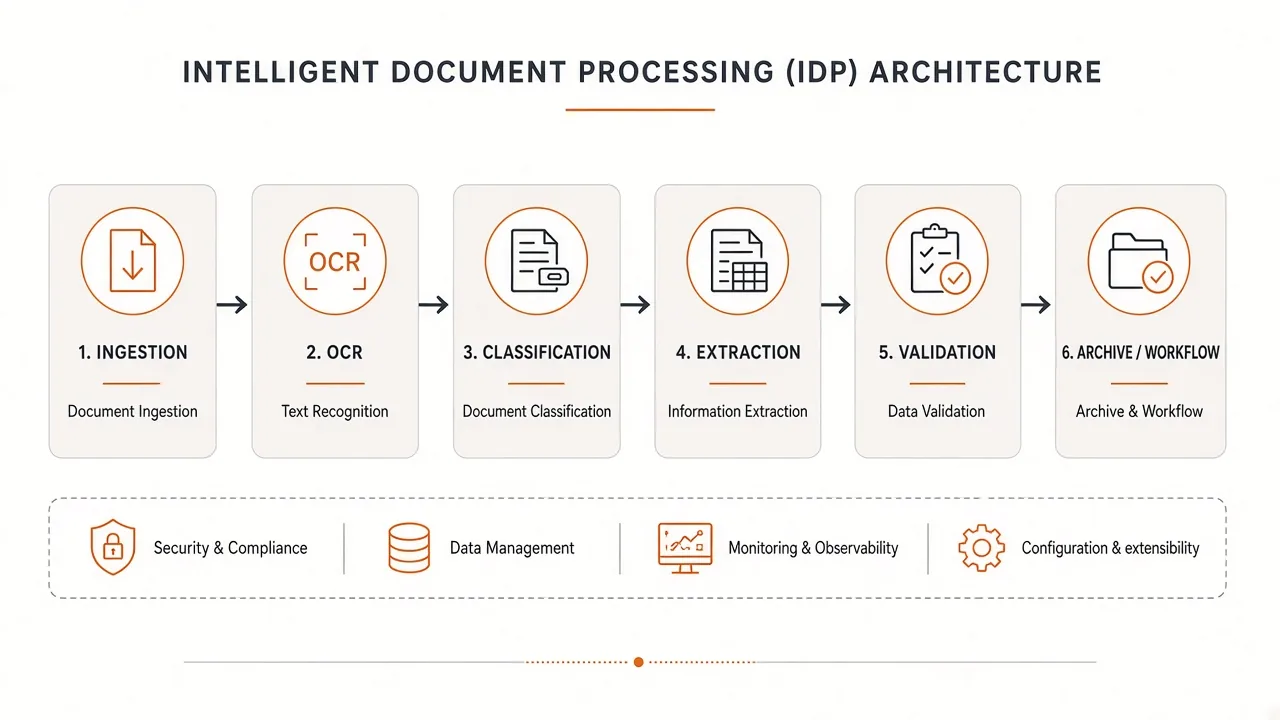
Document AI مجموعهای از فناوریهای OCR، پردازش تصویر، یادگیری ماشین و مدلهای زبانی است که برای استخراج و درک اطلاعات از اسناد غیرساختاریافته استفاده میشود. OCR فقط متن میسازد؛ IDP پردازش انتهابهانتهاست؛ DMS معمولاً ذخیره و مدیریت فایل است.
| فناوری | وظیفه اصلی | مثال |
|---|---|---|
| OCR | تبدیل تصویر/اسکن به متن | خواندن PDF اسکنشده |
| Document AI | درک ساختار و محتوای سند | تشخیص نوع قرارداد و بخشها |
| IDP | پردازش انتهابهانتها | فاکتور → استخراج → ثبت |
| DMS | ذخیره و مدیریت اسناد | بایگانی و کنترل نسخه |
OCR بهتنهایی Document Intelligence نیست؛ بدون درک ساختار، اعتبارسنجی و گردشکار، متن خام ارزش عملیاتی محدودی دارد.
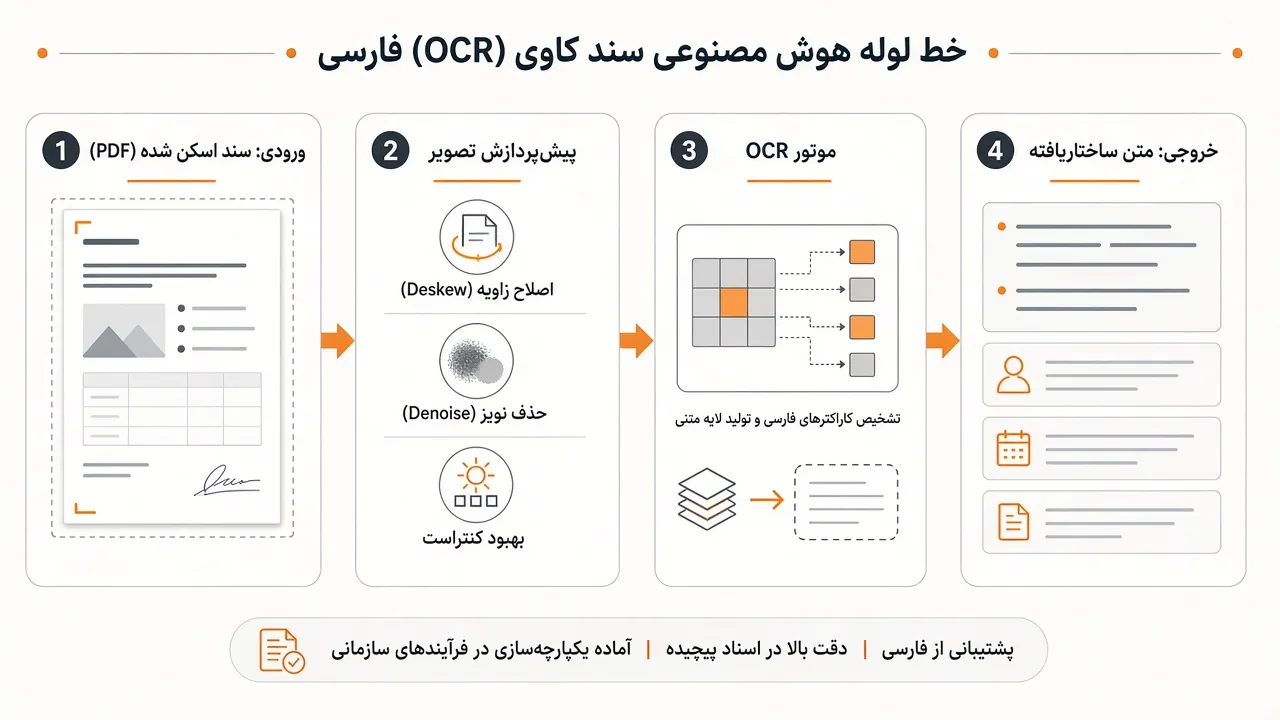
OCR فناوری تبدیل تصویر سند به متن ماشینخوان است. OCR هوشمند معمولاً با پیشپردازش، تحلیل layout، تشخیص جدول/فرم و پسپردازش همراه میشود تا خروجی برای استخراج و جستجو قابل اتکاتر باشد.
دقت OCR به کیفیت تصویر، فونت، layout، زبان و نوع سند وابسته است. ادعای تشخیص دستنویس یا تأیید امضا بدون پشتیبانی واقعی پروژه مطرح نمیشود.
برای سنجش دقت واقعی، روی نمونه اسناد خودتان پایلوت OCR اجرا میکنیم.
بررسی پایلوت OCR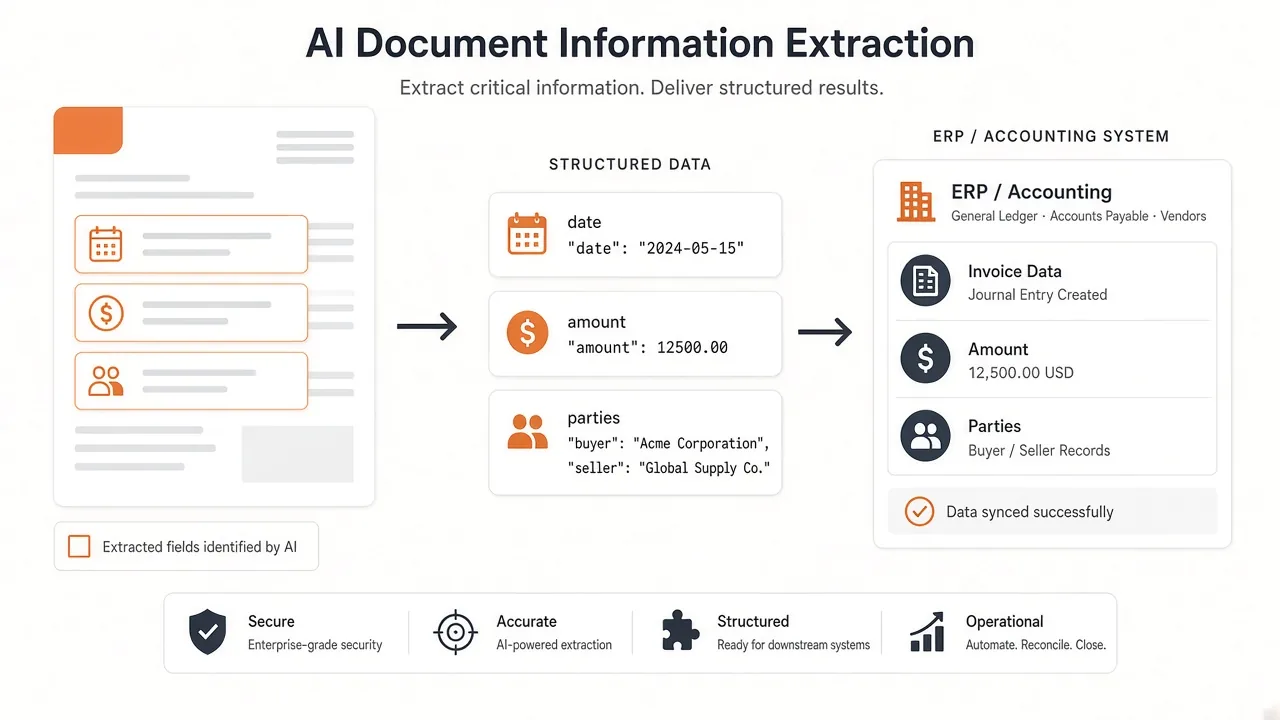
استخراج اطلاعات (Information Extraction) فیلدها و موجودیتهای مهم را از متن/تصویر سند به داده ساختیافته تبدیل میکند.
شماره، تاریخ، تأمینکننده، خریدار، مبلغ کل، مالیات، اقلام سطری.
طرفین، تاریخ اجرا/انقضا، مبالغ، تعهدات، فسخ، تمدید، جریمه.
نام، شناسه، تاریخها و فیلدهای انتخابشده.
فرستنده، گیرنده، موضوع، واحد و اقدامات لازم.
اینها مثالهای رایج هستند نه نتیجه تضمینشده پروژه خاص. قبل از ثبت در سیستمهای مالی، Validation و در موارد حساس Human Review ضروری است.
جدولها بهدلیل سلول ادغامشده، چندصفحهای بودن، اعداد فارسی و جمعهای فرعی دشوارند. هدف: تبدیل ردیف/ستون به داده ساختیافته قابل اعتبارسنجی. خروجی جدول قبل از ورود به ERP/حسابداری باید بررسی شود؛ خطای یک سلول میتواند ثبت مالی را خراب کند.
طبقهبندی (Document Classification) نوع مدرک را مشخص میکند: قرارداد، فاکتور، رسید، نامه، فرم، گزارش، پرونده، آییننامه، مدارک هویتی، مستندات فنی. میتواند مبتنی بر قواعد، مدل ML یا ترکیب هر دو باشد.
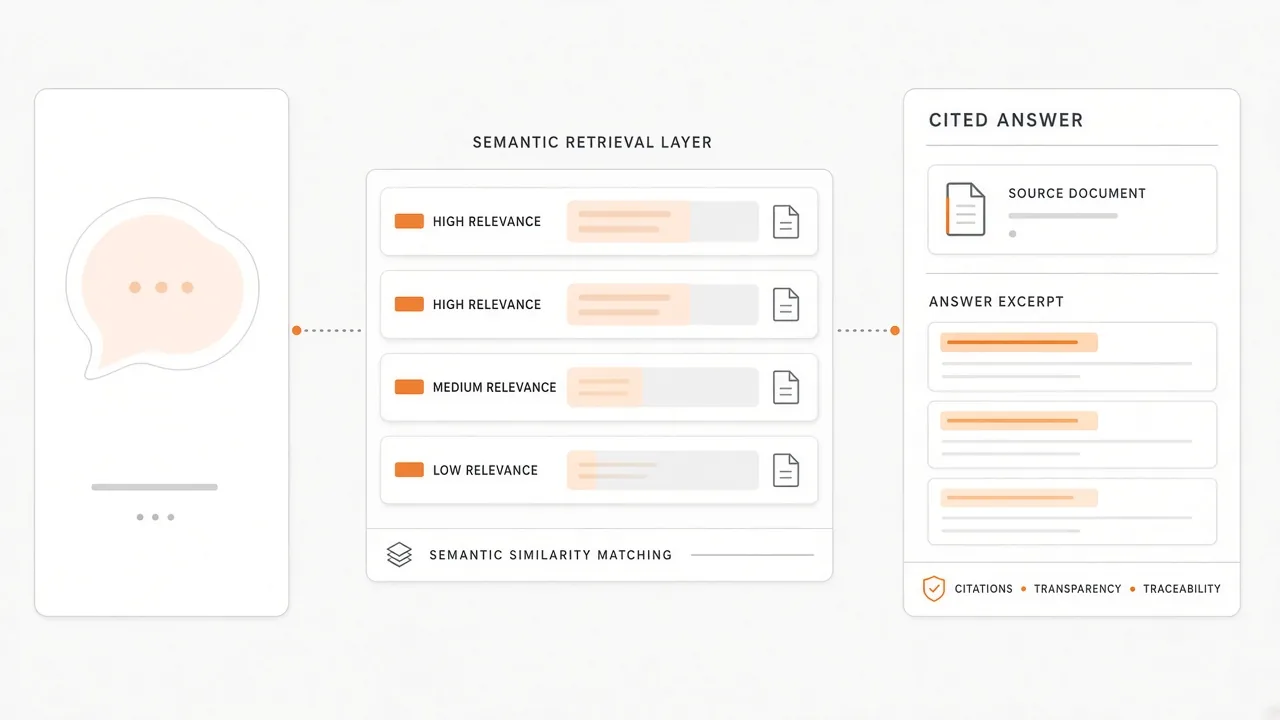
جستجوی معنایی اسناد تلاش میکند بخشهای مفهوماً مرتبط را پیدا کند، حتی وقتی کلیدواژه دقیق یکی نیست. این یعنی «درک کامل» سند نیست؛ بازیابی بهتر از جستجوی کلیدواژهای محض است.
| نوع | مثال پرسش | رفتار |
|---|---|---|
| کلیدواژهای | «فسخ قرارداد» | وابسته به کلمه دقیق |
| معنایی | «شرایط پایان دادن زودتر از موعد چیست؟» | پیدا کردن بندهای مرتبط حتی با واژگان متفاوت |
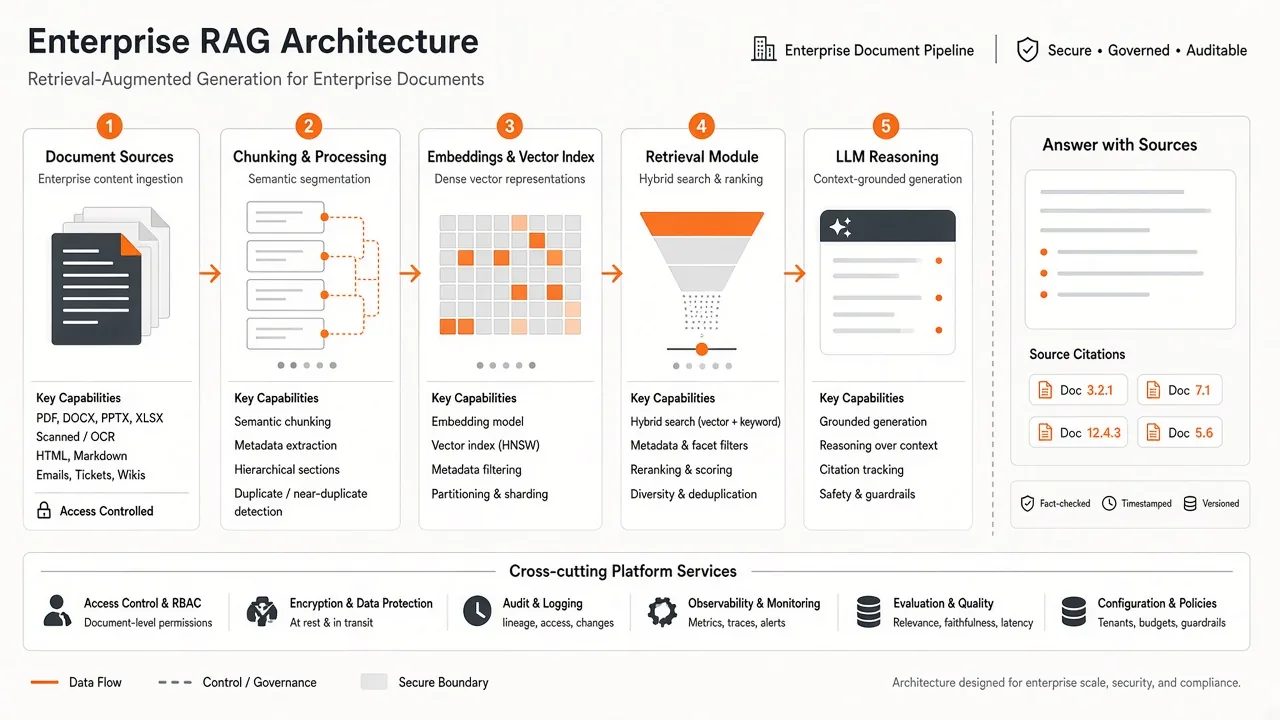
RAG (Retrieval Augmented Generation) برای اسناد سازمانی پاسخ را به محتوای بازیابیشده متصل میکند. معماری معمول:
پاسخ باید منبع سند، بخش مرتبط و در صورت امکان صفحه/چانک را نشان دهد. ریسکها: خطای OCR، بازیابی اشتباه، سند منسوخ، تعارض اسناد، اشتباه دسترسی، hallucination مدل. کنترلها: پاسخ grounded، RBAC، نسخهبندی، سیگنال اطمینان، Human Review برای تصمیم حساس، Logging. جزئیات معماری دستیار: RAG و دستیار سازمانی.
برای پرسش روی آییننامه و دانش محصول، ابتدا دامنه اسناد و دسترسی تعریف میشود.
بررسی جستجوی هوشمند اسنادنمونههای رایج: «آخرین مهلت تمدید قرارداد چیست؟» / «کدام قراردادها ماه آینده منقضی میشوند؟» / «شرایط پرداخت این قرارداد چیست؟» / «در آییننامه منابع انسانی درباره مرخصی چه آمده؟» / «این پرونده چه مدارکی کم دارد؟»
پاسخ تولیدشده بهخودیخود مرجع نهایی نیست؛ باید به منبع grounded شود و در حوزههای حساس بازبینی شود.
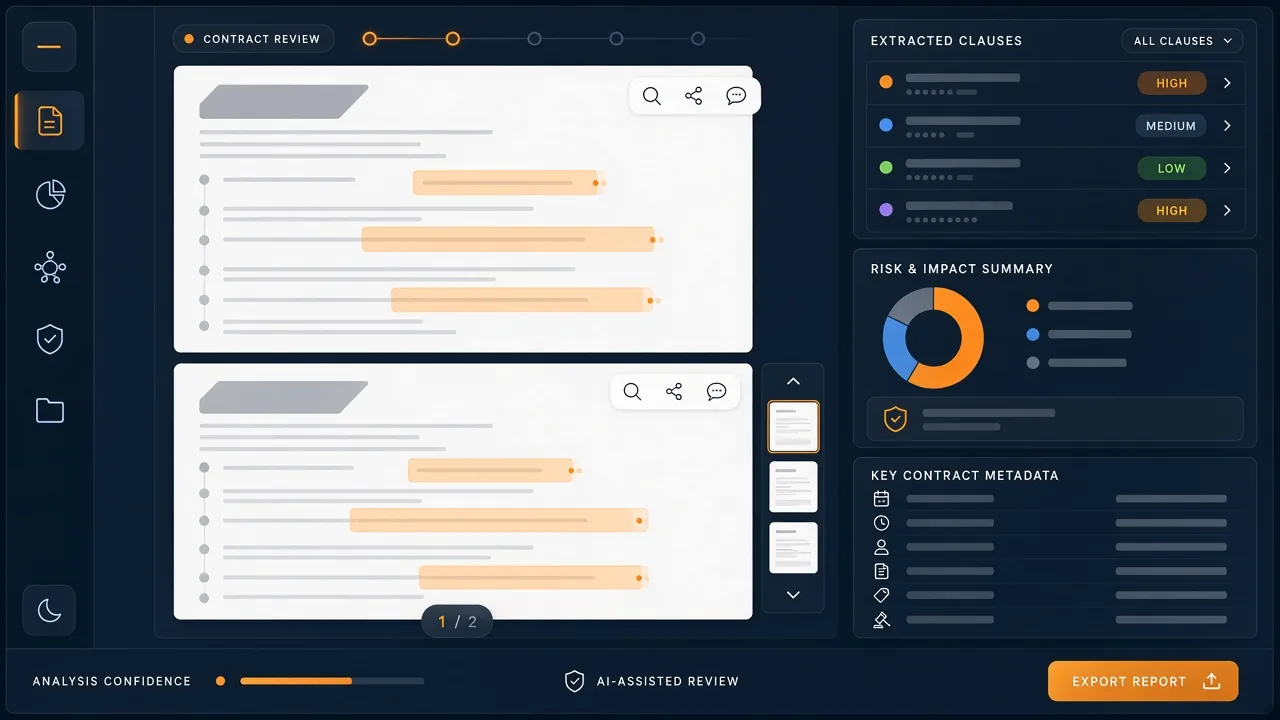
قراردادخوانی با AI برای کمک به بررسی و استخراج اطلاعات قرارداد است — نه جایگزین وکیل. قابلیتهای رایج: استخراج بند، طرفین، تاریخها، تعهدات، پرداخت، جریمه، تمدید، فسخ، خلاصه، و در صورت طراحی تشخیص بندهای مفقود یا مقایسه نسخهها.
مرتبط: هوش مصنوعی حقوقی و قرارداد. تصمیم حقوقی نهایی باید با بازبینی متخصص انجام شود.
چالشها: تنوع layout، اسکن ضعیف، اعداد فارسی/عربی، فیلد مالیات، افزودههای دستی. تشخیص تکراری بودن فاکتور فقط وقتی در دامنه پروژه طراحی شده باشد ادعا میشود.
مقایسه نسخه قدیم/جدید قرارداد یا آییننامه، دو پیشنهاد تجاری یا دو Policy میتواند بهعنوان ماژول اختیاری پیادهسازی شود: بندهای تغییر کرده، اضافهشده، حذفشده و مقادیر/تاریخهای تغییر یافته. فقط در صورت نیاز دامنه پروژه فعال میشود.
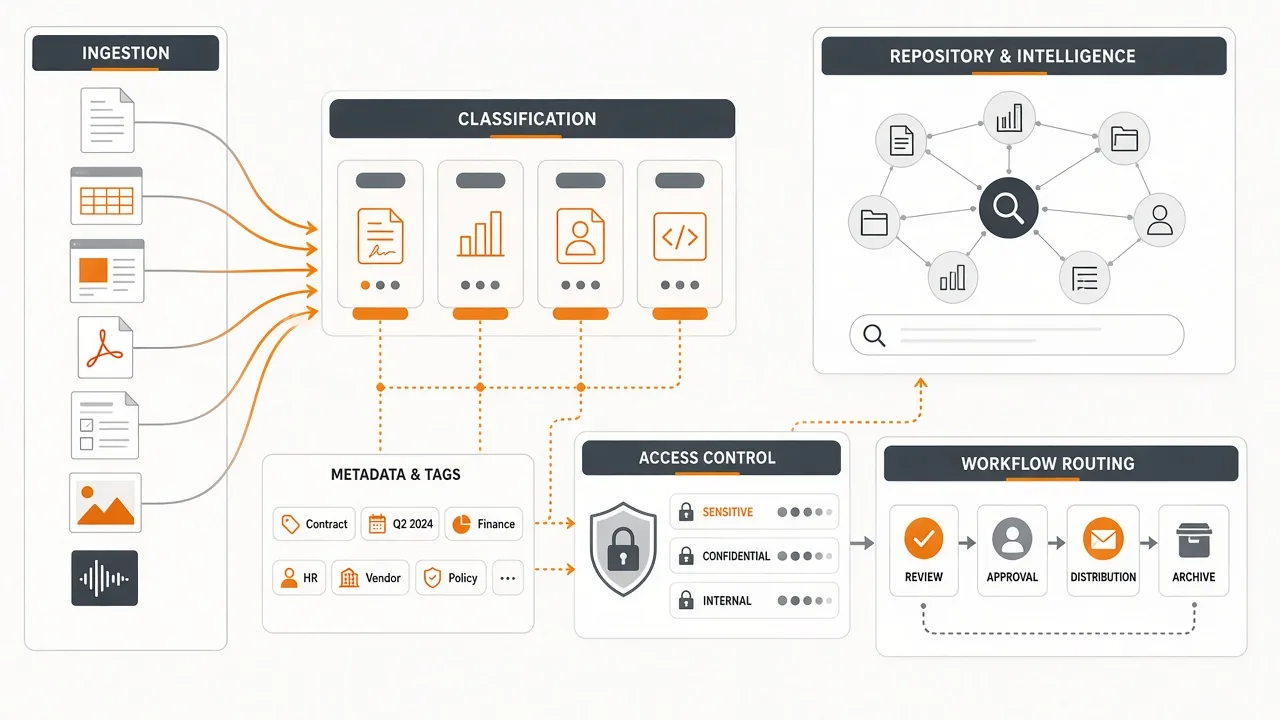
بایگانی سنتی عمدتاً پوشه + نام فایل + متادیتای دستی است. بایگانی هوشمند محتوا را درک میکند، متادیتا و طبقهبندی میسازد، جستجوی معنایی میدهد و دسترسی را کنترل میکند. موضوعات: متادیتا، تگ، چرخه عمر، نسخهبندی، Retention در صورت تعریف سیاست، RBAC، Audit Log. ادعای انطباق با استاندارد خاص بدون پیادهسازی واقعی مطرح نمیشود.
| ویژگی | DMS سنتی (معمولاً) | AI Document Management |
|---|---|---|
| ذخیره فایل | بله | بله |
| مدیریت نسخه | بله | بله |
| OCR | محدود / وابسته به سیستم | خط لوله OCR/AI |
| استخراج اطلاعات | دستی / قواعد | کمکشده با AI |
| جستجوی معنایی | معمولاً محدود | قابل طراحی |
| پرسش روی محتوا | محدود | قابل طراحی |
| طبقهبندی خودکار | محدود | قابل طراحی |
| خلاصهسازی | معمولاً ندارد | قابل طراحی |
| گردشکار | بله | بله + پردازش هوشمند |
محصولات DMS متفاوتاند؛ جدول بالا الگوی رایج است نه حکم مطلق درباره همه سامانهها.
ساخت سامانه کامل میتواند در قالب توسعه نرمافزار هوش مصنوعی و استقرار آن در پیادهسازی AI انجام شود.
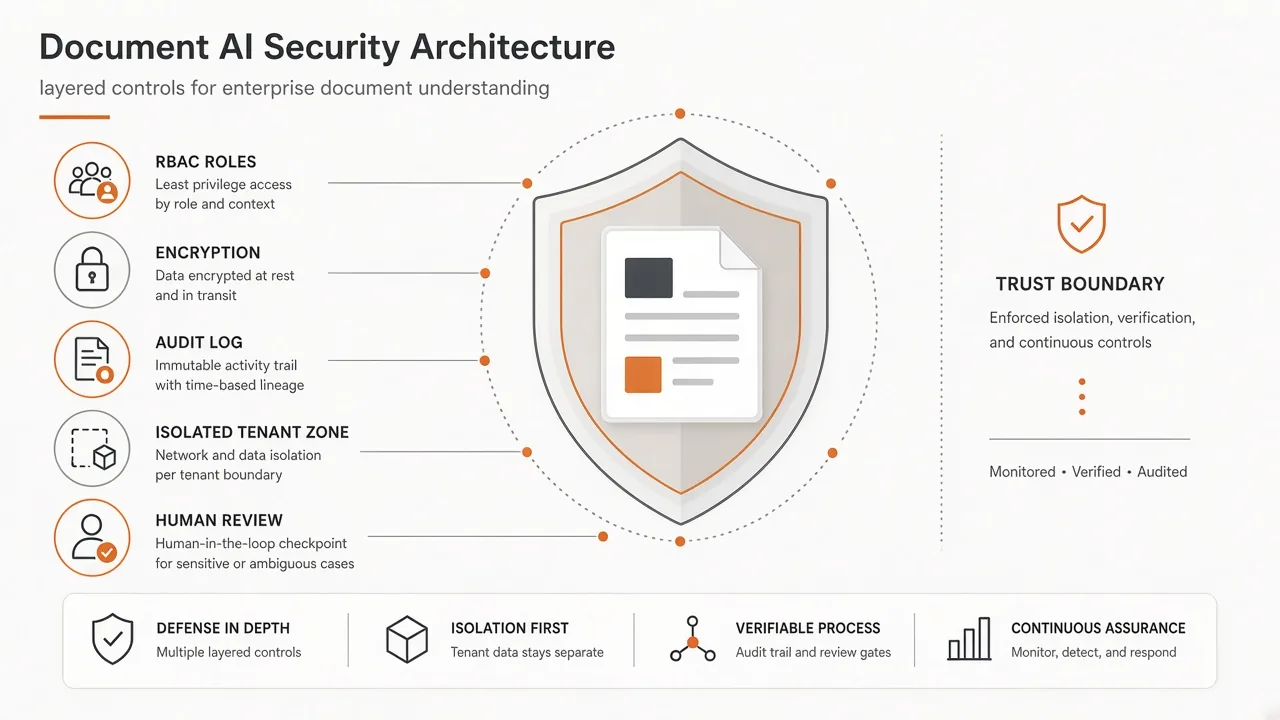
امنیت ۱۰۰٪ تضمین نمیشود و گواهیهایی مثل ISO/SOC بدون داشتن واقعی ادعا نمیشوند. برای پرسش روی اسناد، کنترل دسترسی روی Retrieval حیاتی است.
در پروژههای محرمانه، معماری امن از روز اول طراحی میشود.
مشاوره معماری امن Document AIخطا میتواند از OCR، استخراج، بازیابی یا تولید متن مدل بیاید. کنترلهای مفید:
این بخش برای اعتماد سازمانی و E-E-A-T مهم است: شفافیت محدودیتها بهتر از ادعای بدون خطا است.
قراردادهای حقوقی، اسناد مالی پرارزش، مدارک پزشکی، تراکنشهای حساس، اسناد انطباق و اطلاعات شخصی حساس معمولاً نیاز به Human-in-the-loop دارند. AI باید پردازش تکراری را کمک کند؛ تصمیم پراثر نباید بدون طراحی، ارزیابی و حاکمیت خودکار شود.
دامنه دقیق پس از بررسی نمونههای واقعی سازمان تعیین میشود.
استخراج بند و تاریخ؛ کاهش زمان مرور اولیه. ریسک: نیاز به بازبینی حقوقی. حقوقی و قرارداد
فاکتور و جدول؛ تسریع ثبت. ریسک: Validation قبل از ERP.
پرونده و کمبود مدرک؛ تسریع بررسی اولیه. بیمه و مالی
مدارک مشتری و فرمها؛ کنترل دسترسی سختگیرانه.
سازماندهی مدارک با کنترل دسترسی. سلامت
رزومه، قرارداد کار، فرمها. HR
مکاتبات و آییننامهها؛ جستجو و بایگانی.
بارنامه و مدارک حمل. لجستیک
پیشنهاد، قرارداد فروش، فاکتور. فروش
راهنما و دانش محصول با RAG. پشتیبانی
مناسب وقتی: حجم سند بالاست، ورود داده دستی زیاد است، اطلاعات در PDF گیر کرده، جستجو زمانبر است، انواع مدرک متعددند، کانالهای ورودی متنوعاند، ERP/DMS هست اما محتوا غیرساختاریافته مانده، و قابلیت حسابرسی مهم است.
معمولاً منطقی نیست وقتی: حجم خیلی کم است، اسناد از قبل ساختیافتهاند، پردازش دستی ارزان و کافی است، گردشکار معناداری وجود ندارد، یا کیفیت منبع بدون برنامه پیشپردازش بسیار ضعیف است.
مسیر کلی پروژه در مشاوره هوش مصنوعی و پیادهسازی AI نیز پوشش داده میشود؛ این صفحه روی لایه اسناد متمرکز است.
پایلوت نباید همزمان همه چیز را پوشش دهد. پیشنهاد: یک نوع سند پرتکرار + OCR + استخراج فیلد + سنجش دقت/زمان + گزارش Go/No-Go.
وعده ROI قطعی نمیدهیم؛ KPI پایلوت را شفاف میسنجیم.
| KPI | هدف اندازهگیری |
|---|---|
| OCR Accuracy | کیفیت متن خروجی |
| Field Extraction Accuracy | صحت فیلدهای کلیدی |
| Classification Accuracy | درستی نوع سند |
| Retrieval Precision | ربط نتایج جستجو |
| Answer Groundedness | اتکای پاسخ به منبع |
| Processing Time | سرعت پردازش هر سند |
| Human Review Rate | سهم بازبینی انسانی |
| Cost per Document | هزینه عملیاتی |
| Search Time | زمان یافتن اطلاعات |
| User Adoption | استفاده واقعی تیمها |
چارچوب محاسبه (نه ROI تضمینی):
ارزش بالقوه معمولاً از کاهش زمان ورود داده، بازیابی سریعتر، کاهش ورود تکراری و تسریع گردشکار میآید — بدون وعده درصد ثابت.
قیمتهای صفحه تقریبیاند و با پیشوند «از» اعلام میشوند. عوامل مؤثر:
| عامل | اثر روی هزینه |
|---|---|
| حجم اسناد | پردازش و زیرساخت |
| تعداد انواع سند | طراحی مدل/قواعد بیشتر |
| پیچیدگی OCR | کیفیت اسکن و layout |
| پیچیدگی استخراج | فیلد و جدول |
| RAG / جستجو | ایندکس و UI |
| یکپارچهسازی ERP/DMS | توسعه و تست |
| امنیت و استقرار خصوصی | معماری و سختگیری |
| گردشکار و پنل ادمین | توسعه محصول |
| مانیتورینگ و نگهداری | هزینه مستمر |
قیمت نهایی پس از نیازسنجی اعلام میشود.
زمان فعلی صفحه حفظ میشود: پایلوت معمولاً ۲ تا ۴ هفته؛ استقرار کامل معمولاً ۶ تا ۱۲ هفته. پیچیدگی سند، تعداد انواع مدرک، یکپارچهسازی، کیفیت داده، امنیت و گردش تایید روی زمان اثر دارند. تحویل قطعی بدون بررسی دامنه وعده داده نمیشود.
بسته مناسب نوع مدارک، حجم پردازش و سطح جستجو را انتخاب کنید؛ مبلغ نهایی پس از نیازسنجی اعلام میشود.
مبالغ زیر تقریبی و با پیشوند «از» هستند. تنوع اسناد، کیفیت اسکن، نیاز به فارسی تخصصی و سطح امنیت میتواند قیمت را تغییر دهد.
از ۷۰ میلیون تومان
از ۱۳۵ میلیون تومان
کارشناسی اختصاصی
سایر راهکارهای هوش مصنوعی · حقوقی و قرارداد هوشمند · بیمه و خدمات مالی هوشمند
هوش مصنوعی مدیریت اسناد به استفاده از OCR، درک سند، یادگیری ماشین، مدلهای زبانی و بازیابی برای تبدیل اسناد غیرساختاریافته به اطلاعات قابل جستجو، ساختیافته و قابل اقدام گفته میشود.
Document AI مجموعهای از فناوریهای OCR، پردازش تصویر، یادگیری ماشین و مدلهای زبانی است که برای استخراج و درک اطلاعات از اسناد غیرساختاریافته استفاده میشود.
IDP پردازش انتهابهانتهای سند است: از دریافت فایل تا OCR، طبقهبندی، استخراج، اعتبارسنجی و ارسال به گردشکار یا ERP — نه فقط تبدیل تصویر به متن.
OCR تصویر یا اسکن را به متن تبدیل میکند. Document AI ساختار و معنای سند را درک میکند؛ مثلاً نوع قرارداد، فیلدها و بخشهای مهم را تشخیص میدهد.
بله. راهحل برای اسناد فارسی و انگلیسی طراحی میشود و دقت OCR به کیفیت اسکن، فونت، layout و نوع مدرک وابسته است.
بله. PDF اسکنشده و تصویر از ورودیهای رایج هستند؛ در صورت کیفیت پایین، پیشپردازش و ارزیابی دقت قبل از استقرار ضروری است.
در بسیاری از سناریوها بله؛ استخراج جدول به layout، سلولهای ادغامشده و کیفیت اسکن حساس است و قبل از ورود به ERP باید اعتبارسنجی شود.
بله برای کمک به استخراج بندها، تاریخها، طرفین، تعهدات و خلاصه. این کار جایگزین مشاوره حقوقی نیست و در موارد حساس بازبینی انسانی/حقوقی لازم است.
بله. شماره فاکتور، تاریخ، طرفین، مبلغ، مالیات و اقلام سطری از فیلدهای رایجاند؛ تنوع layout و کیفیت اسکن روی دقت اثر میگذارد.
جستجویی که مفهوم پرسش را در نظر میگیرد و حتی وقتی کلمات دقیق یکی نیستند، بخشهای مرتبط سند را پیدا میکند — متفاوت از جستجوی کلیدواژهای محض.
اسناد پس از OCR و Chunking ایندکس میشوند؛ سوال کاربر بخشهای مرتبط را بازیابی میکند و مدل پاسخ grounded با ارجاع به منبع تولید میکند. جزئیات بیشتر در صفحه RAG.
بله در محدوده اسناد مجاز کاربر. پاسخ باید به منبع و بخش مرتبط ارجاع دهد و برای تصمیمهای حساس مبنای خودکار نهایی نباشد.
جستجوی معمولی به کلمات دقیق وابسته است. جستجوی معنایی مفهوم را هدف میگیرد؛ مثلاً «شرایط پایان زودتر از موعد» ممکن است بندی با عنوان «فسخ» را پیدا کند.
لزوماً نه. بسیاری از پروژهها لایه Document AI را روی DMS موجود اضافه میکنند تا استخراج، جستجو و دانش محتوایی تقویت شود.
DMS معمولاً روی ذخیره، نسخه و دسترسی تمرکز دارد. AI Document Management درک محتوا، استخراج، جستجوی معنایی و پرسش روی سند را اضافه میکند — بسته به محصول DMS متفاوت است.
در صورت وجود مسیر یکپارچهسازی مناسب، بله؛ خروجی استخراجشده میتواند پس از Validation به ERP ارسال شود.
معمولاً بله؛ متادیتا و خروجی استخراج به فضای بایگانی یا DMS موجود منتقل میشود تا فرآیند فعلی مختل نشود.
با RBAC، رمزنگاری در انتقال و ذخیره، Audit Log، کنترل دسترسی سطح سند، Masking فیلدهای حساس و در صورت نیاز استقرار روی زیرساخت سازمان. امنیت مطلق ادعا نمیشود.
در بسیاری از پروژههای سازمانی بله؛ گزینه استقرار روی زیرساخت مشتری در نیازسنجی بررسی میشود.
دقت قطعی و ثابت نیست؛ به کیفیت اسکن، فونت، layout، زبان و نوع سند وابسته است. در پایلوت روی نمونه واقعی شما اندازهگیری میشود.
با Validation قواعد، آستانه اطمینان، ارجاع به منبع، Structured Output، Human Review در موارد حساس، Logging و مانیتورینگ کیفیت.
برای قراردادهای حقوقی، اسناد مالی حساس، مدارک پزشکی و تراکنشهای پرارزش معمولاً بله. AI کمککننده است نه تصمیمگیر خودکار بدون حاکمیت.
پایلوت روی یک نوع سند معمولاً ۲ تا ۴ هفته و استقرار کامل با چند نوع مدرک، جستجو و یکپارچهسازی معمولاً ۶ تا ۱۲ هفته طول میکشد.
پایلوت از حدود ۷۰ میلیون تومان، سامانه چندنوع سند با جستجوی معنایی از حدود ۱۳۵ میلیون تومان و راهحل سازمانی با کارشناسی اختصاصی آغاز میشود. قیمت نهایی پس از نیازسنجی اعلام میگردد.
معمولاً یک نوع سند پرتکرار با فیلدهای مشخص مثل فاکتور یا قرارداد استاندارد. پایلوت نباید همزمان همه انواع مدرک را پوشش دهد.