
مثال RAG
کاربر درباره سیاست مرخصی سؤال میکند → سیستم سند مرتبط را پیدا میکند → پاسخ میدهد و منبع را نشان میدهد.

سیستمهای Retrieval-Augmented Generation برای پاسخگویی روی اسناد، پایگاه دانش و دانش داخلی شرکت؛ با Citation، کنترل دسترسی و ارزیابی کیفیت.
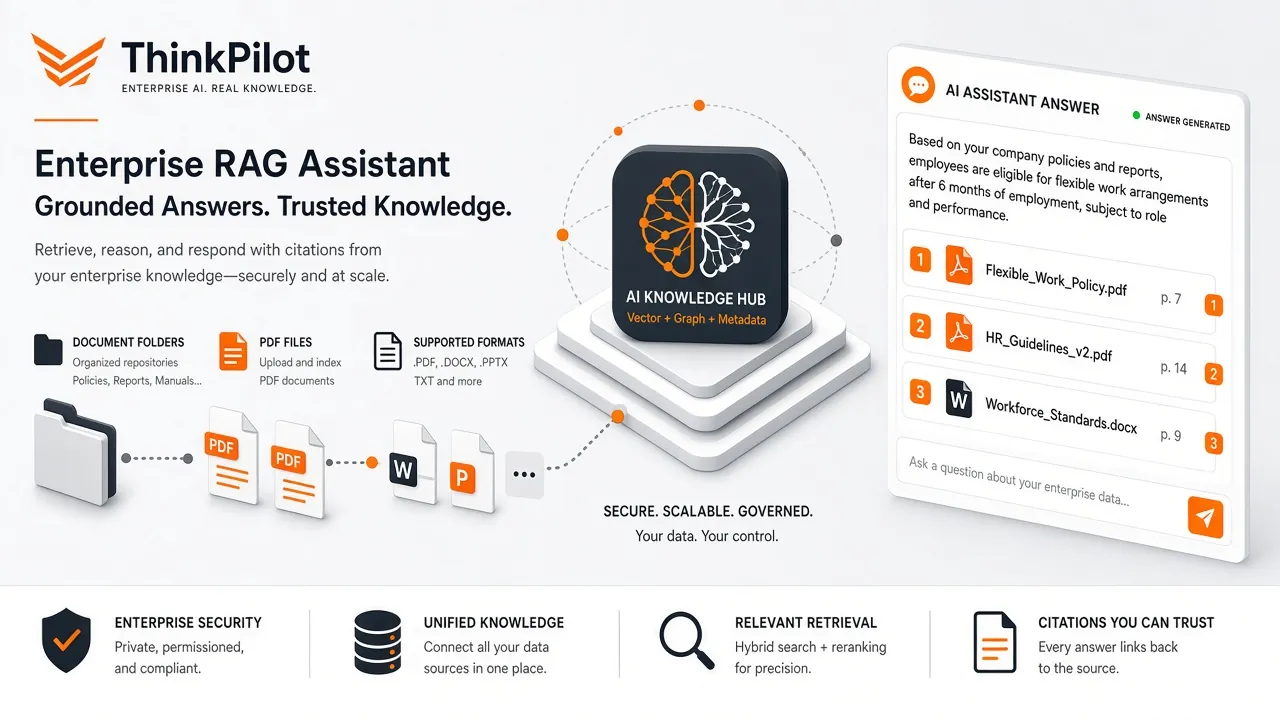
RAG یا Retrieval-Augmented Generation معماریای است که قبل از تولید پاسخ توسط مدل زبانی (LLM)، اطلاعات مرتبط را از یک منبع دانش خارجی—معمولاً اسناد و پایگاه دانش سازمان—بازیابی و به مدل میدهد. هدف: پاسخ نزدیکتر به دانش واقعی شرکت، قابلاستنادتر، و با احتمال کمتر hallucination نسبت به چت بدون منبع.
سازمانها معمولاً با این مسئله روبهرو هستند: دانش در PDF، ویکی داخلی، قراردادها، FAQ و سیستمهای مختلف پراکنده است؛ جستجوی واژهای مفهوم سؤال را نمیفهمد؛ و مدل عمومی، آییننامه و محصول شما را نمیشناسد. پیادهسازی RAG لایه دانشی میسازد که دستیار هوش مصنوعی سازمانی بتواند روی همان منابع پاسخ بدهد.
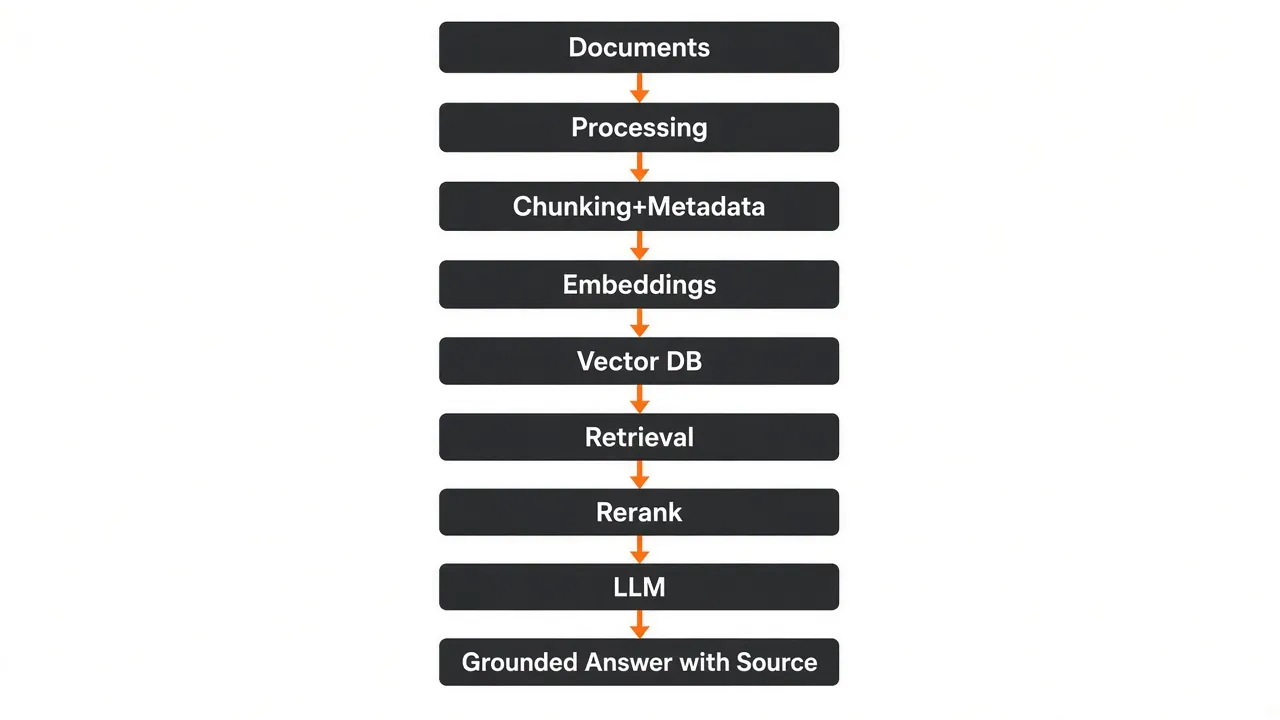
در ThinkPilot، RAG را بهعنوان اتصال ساده یک فایل به چتبات نمیبینیم. طراحی شامل Document Processing، Chunking، Embedding، Vector Database، Retrieval، Reranking، Citation، Access Control و Evaluation است. تفاوت یک سیستم RAG سازمانی با chatbot ساده همین لایه بازیابی کنترلشده و قابل اندازهگیری است—نه فقط ظاهر گفتوگو.
RAG مخفف Retrieval-Augmented Generation است: تولید پاسخ تقویتشده با بازیابی. مدل زبانی پاسخ را «از حافظه آموزش» حدس نمیزند؛ ابتدا بخشهای مرتبط دانش را میگیرد، سپس روی همان Context پاسخ میسازد.
اجزای اصلی معمولاً اینها هستند:
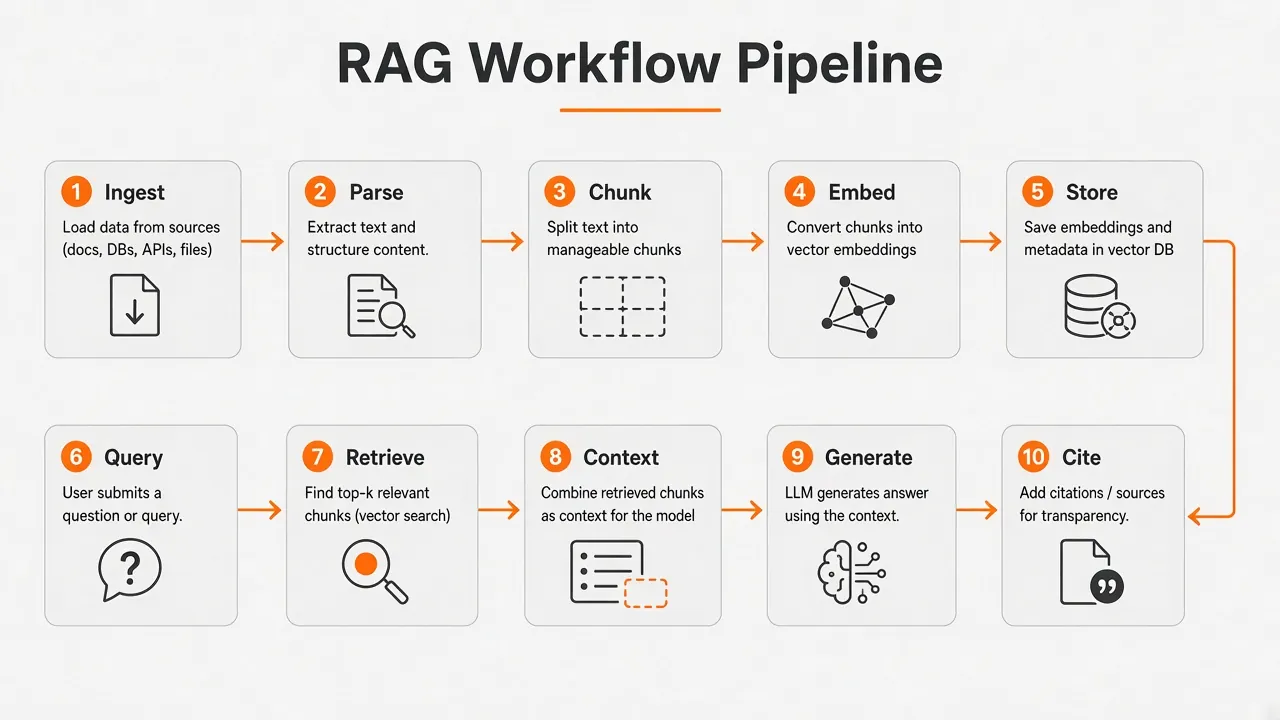
جریان ساده و قابل فهم:
مسئله: اطلاعات شرکت در فایلها و سامانههای متعدد است.
نقش RAG: یک لایه جستجوی هوشمند روی دانش تأییدشده میسازد.
مسئله: کارکنان وقت زیادی برای یافتن آییننامه و FAQ میگذارند.
نقش RAG: پرسشوپاسخ مستقیم روی اسناد با ارجاع منبع.
مسئله: جستجوی سنتی مفهوم سؤال را درک نمیکند.
نقش RAG: Semantic Search و در صورت نیاز Hybrid Search.
مسئله: LLM عمومی محصول و سیاست شما را نمیداند.
نقش RAG: تزریق دانش سازمان در زمان پاسخ.
مسئله: مدل ممکن است با اطمینان پاسخ نادرست بسازد.
نقش RAG: Grounding روی اسناد + Citation + رفتار «نمیدانم».
مسئله: اسناد عوض میشوند و سطح دسترسی مهم است.
نقش RAG: بهروزرسانی ایندکس و فیلتر دسترسی در Retrieval.
اگر دانش سازمان در اسناد و سیستمهاست و نیاز به دستیار قابلاستناد دارید، دامنه را بررسی میکنیم.
درخواست بررسی پروژه RAGچتبات معمولی اغلب روی اسکریپت، FAQ ثابت یا دانش عمومی مدل کار میکند. دستیار مبتنی بر RAG روی دانش داخلی سازمان بازیابی میکند و معمولاً منبع نشان میدهد.
| معیار | چتبات معمولی | دستیار مبتنی بر RAG |
|---|---|---|
| منبع دانش | اسکریپت / دانش عمومی مدل | اسناد و پایگاه دانش سازمان |
| دسترسی به اسناد شرکت | معمولاً ندارد | با Retrieval کنترلشده |
| بهروزرسانی دانش | دشوار / دستی | با بهروزرسانی ایندکس اسناد |
| Citation | معمولاً ندارد | قابل طراحی و نمایش |
| کنترل دسترسی | محدود به سطح گفتوگو | فیلتر سند / نقش کاربر |
| Hallucination | ریسک بالاتر بدون منبع | کاهشیافته با Grounding (نه صفر مطلق) |
| اتصال به سیستمهای سازمانی | اغلب سطحی | قابل اتصال به DMS / CRM / API |
| قابلیت توسعه | محدود به سناریوهای ثابت | قابل گسترش به Hybrid Search و Agent |
| کاربرد سازمانی | FAQ و گفتوگوی ساده | پرسشوپاسخ روی دانش داخلی |
پاسخ کوتاه: برای دانش متغیر سازمان معمولاً RAG مناسبتر است؛ برای رفتار و سبک مدل، Fine-tuning. این دو رقیب مطلق نیستند و میتوانند ترکیب شوند.
RAG برای: آییننامهها، قراردادها، FAQ، کاتالوگ محصول، دانش داخلی و اطلاعاتی که مدام عوض میشوند.
Fine-tuning برای: سبک پاسخ، الگوی خروجی خاص، و task-specific behavior وقتی داده آموزشی کافی و پایدار دارید.
| معیار | RAG | Fine-tuning |
|---|---|---|
| هدف اصلی | وصل کردن پاسخ به دانش خارجی | تغییر رفتار/سبک مدل |
| دانش متغیر | قوی | ضعیفتر / پرهزینهتر برای بهروز رسانی |
| Citation | طبیعیتر قابل پیادهسازی | معمولاً مستقیم نیست |
| زمان ورود به بهره | معمولاً سریعتر برای دانش اسناد | نیاز به داده آموزشی و ارزیابی بیشتر |
| ترکیبپذیری | میتواند لایه دانش Agent باشد | میتواند روی مدل پایه RAG اعمال شود |
RAG سازمانی فقط «وصل کردن PDF به LLM» نیست. معماری معمولاً این لایهها را پوشش میدهد:
جزئیات استک و مرز سرویس در پیادهسازی هوش مصنوعی و در صورت نیاز در مشاوره هوش مصنوعی شفاف میشود.
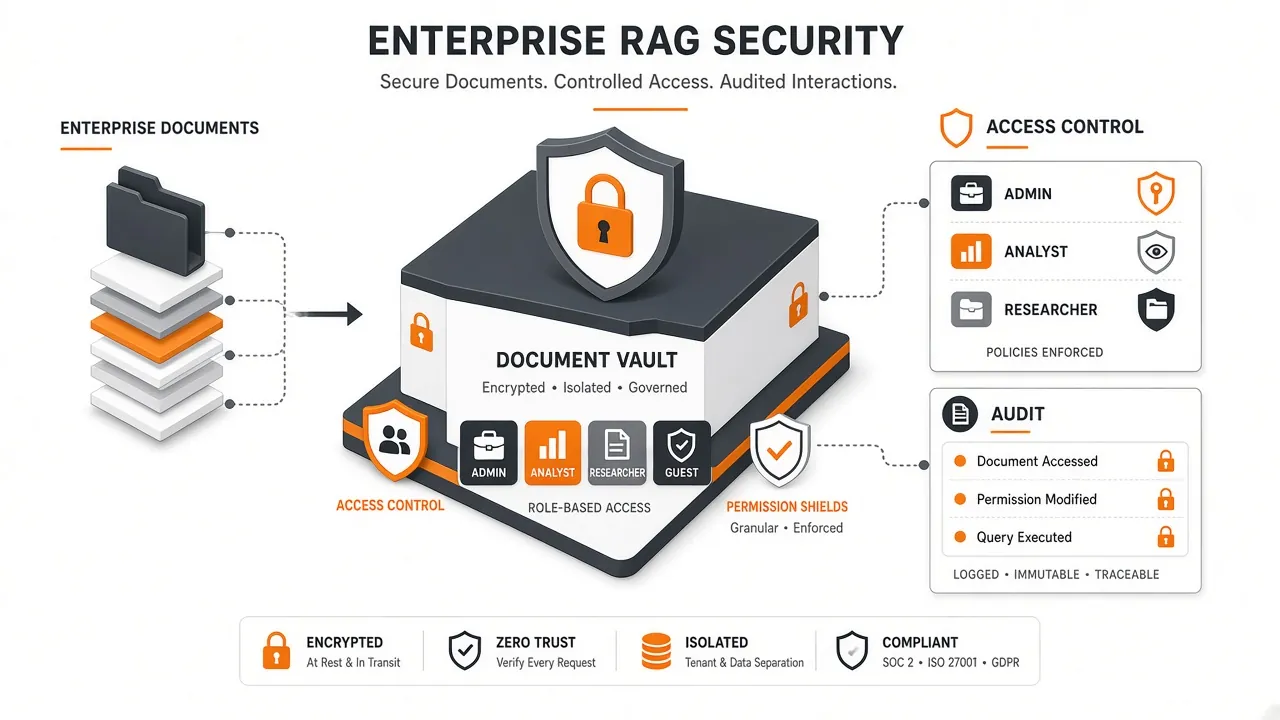
سیستم نباید اطلاعاتی را بازیابی کند که کاربر مجاز به مشاهده آن نیست. بسته به دامنه، این موارد طراحی میشوند:
سطح امنیت مطلق اعلام نمیشود؛ کنترلها متناسب با حساسیت داده و معماری توافقشده تنظیم میگردند.
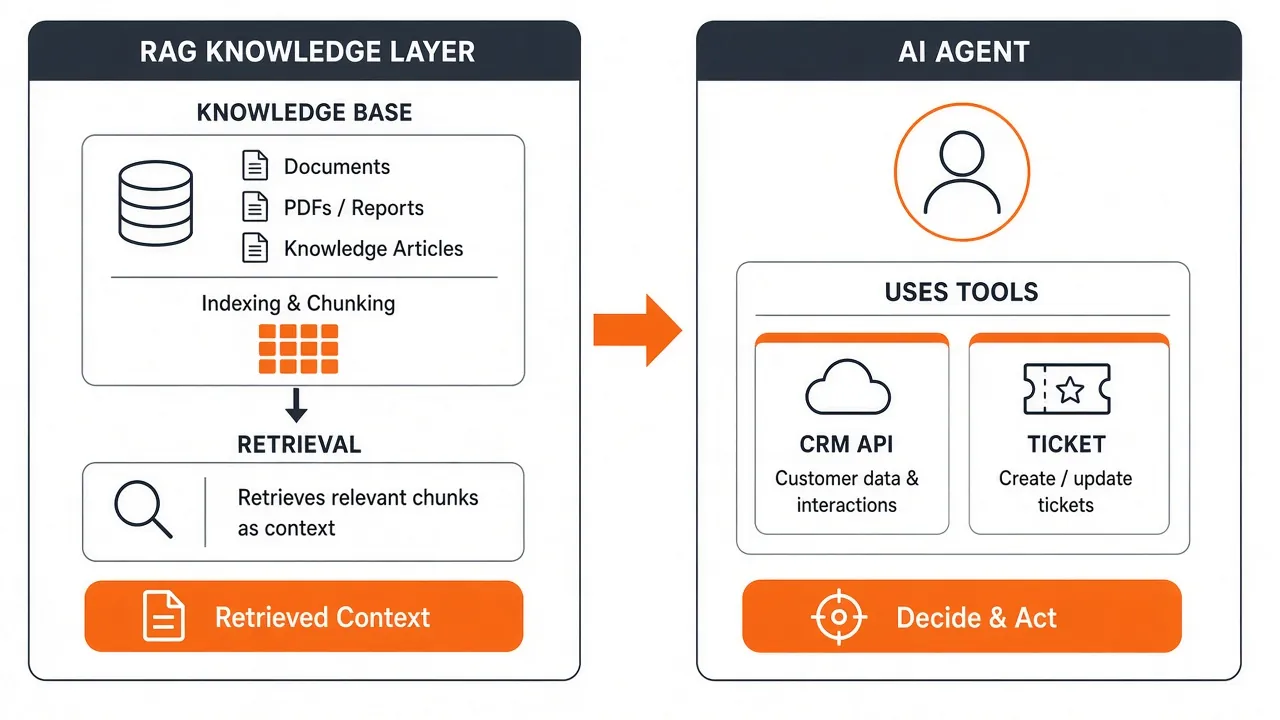
RAG لایه دانش و بازیابی اطلاعات است. AI Agent سامانه هدفمحوری است که میتواند ابزارها را فراخوانی کند و عملیات چندمرحلهای انجام دهد.
کاربر درباره سیاست مرخصی سؤال میکند → سیستم سند مرتبط را پیدا میکند → پاسخ میدهد و منبع را نشان میدهد.
کاربر درخواست خاصی میدهد → Agent اطلاعات را از RAG میگیرد → CRM را بررسی میکند → عملیات مجاز را انجام میدهد → نتیجه را ثبت میکند. جزئیات این مسیر در ساخت ایجنت هوش مصنوعی آمده است.
جستجوی آییننامهها و سیاستهای داخلی برای کارکنان. مرتبط: هوش مصنوعی منابع انسانی.
پرسشوپاسخ روی قراردادها و رویهها با Citation. مرتبط: هوش مصنوعی حقوقی و قرارداد.
پاسخ بر اساس کاتالوگ و دانش محصول. مرتبط: هوش مصنوعی فروش و بازاریابی.
پاسخ مبتنی بر مستندات و FAQ. مرتبط: هوش مصنوعی پشتیبانی مشتری.
دسترسی کنترلشده به دستورالعملها و مستندات سیاستی.
دستیار مبتنی بر جزوه و محتوای آموزشی. مرتبط: هوش مصنوعی آموزش و محتوا.
جستجوی پروتکلها با محدودیت دسترسی مناسب. مرتبط: هوش مصنوعی حوزه سلامت.
پرسشوپاسخ روی Documentation و راهنماهای فنی.
جستجوی معنایی و استخراج دانش از فایلها. مرتبط: هوش مصنوعی مدیریت اسناد.
اتصال دانش واحدهای مختلف به یک لایه جستجوی هوشمند با کنترل دسترسی.
Use Case شما مشخص است؟ نوع اسناد، کاربران و هدف پاسخ را بفرستید تا مسیر MVP را پیشنهاد دهیم.
درخواست بررسی پروژه RAGفرض کنید سازمانی حدود ۵۰۰۰ سند داخلی دارد: قرارداد، دستورالعمل، کاتالوگ، FAQ و مستندات فنی. کارمند میپرسد:
«شرایط تمدید قرارداد مشتری در نسخه جدید آییننامه چیست؟»
قصد کاربر و کلیدواژههای قراردادی مشخص میشود.
Semantic / Hybrid Search روی ایندکس دانش اجرا میشود.
فقط اسنادی که کاربر مجاز است وارد Context میشوند.
قطعههای مربوط به تمدید قرارداد انتخاب و Rerank میشوند.
LLM بر اساس Context پاسخ میسازد.
Citation به آییننامه و بخش مبنا نمایش داده میشود.
RAG همیشه بهترین مسیر نیست. در این حالتها معمولاً گزینه دیگری مناسبتر است:
قیمت ساختگی اعلام نمیکنیم. برآورد به این عوامل بستگی دارد:
دامنه را کوتاه بفرستید تا عوامل هزینه و فاز MVP را شفاف کنیم.
درخواست بررسی پروژه RAG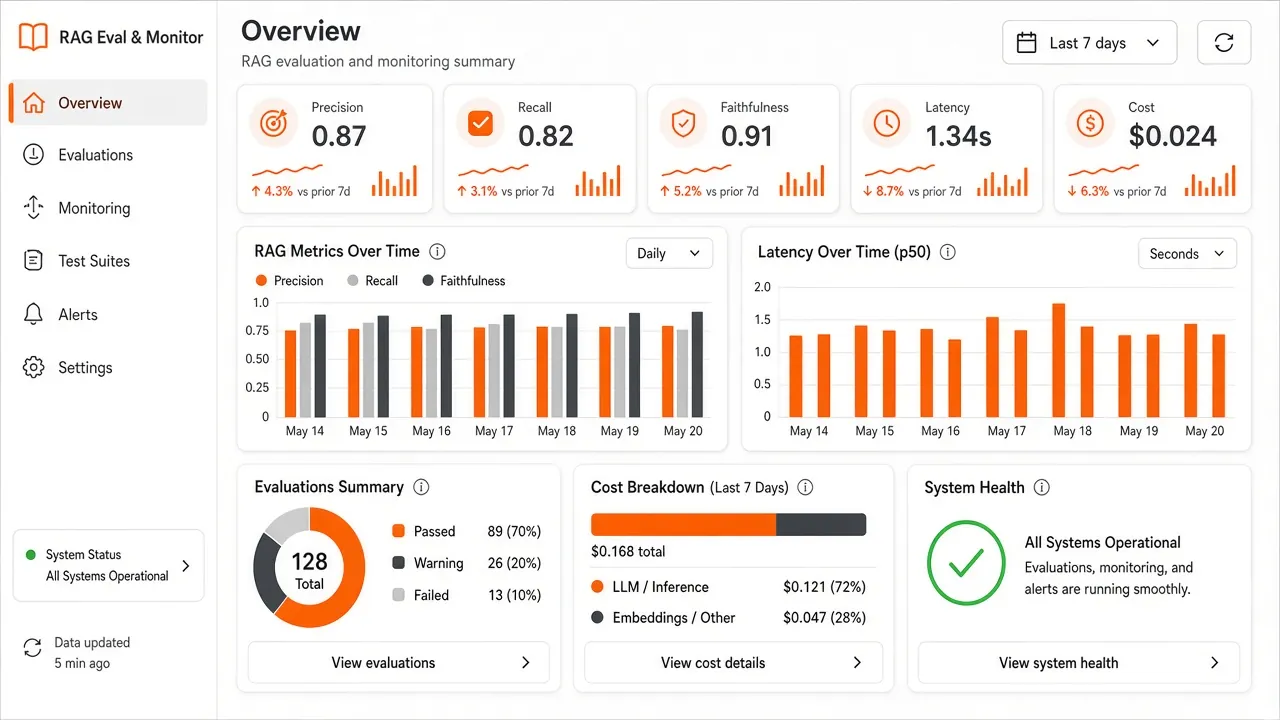
شاخصهای رایج ارزیابی:
RAG اغلب کنار این خدمات معنا پیدا میکند:
برای محصولمحورها و استارتاپها: هوش مصنوعی در محصول و استارتاپ. مرور کلی خدمات در مرکز خدمات هوش مصنوعی و مفاهیم پایه در دانشنامه.
RAG یا Retrieval-Augmented Generation معماریای است که قبل از تولید پاسخ توسط مدل زبانی، اطلاعات مرتبط را از منبع دانش خارجی بازیابی و به مدل میدهد تا پاسخ به اسناد واقعی متکی باشد.
اسناد پردازش و تکهبندی میشوند، Embedding ساخته و در Vector Database ذخیره میشود؛ پس از سؤال کاربر، بخشهای مرتبط بازیابی، Context ساخته و به LLM ارسال میشود تا پاسخ همراه منبع تولید شود.
مدل عمومی فقط از دانش آموزشدیدهاش پاسخ میدهد و اسناد خصوصی شما را نمیشناسد. در RAG پاسخ با بازیابی از دانش سازمان غنی میشود و معمولاً قابل استناد است.
RAG برای دانش متغیر و اسناد سازمان مناسب است. Fine-tuning بیشتر برای رفتار، سبک و الگوی خروجی به کار میرود. این دو میتوانند در یک معماری ترکیب شوند.
بله؛ PDF از منابع رایج است. کیفیت به استخراج متن، ساختار سند، OCR در صورت نیاز و Chunking بستگی دارد.
بله. برای فارسی باید Embedding، Chunking و ارزیابی کیفیت با نمونه پرسشهای واقعی فارسی تنظیم شود.
در صورت وجود API یا روش یکپارچهسازی مناسب، RAG میتواند به دانش محصول/مشتری در CRM وصل شود یا لایه دانش یک Agent متصل به CRM باشد.
اگر دادهها و مستندات ERP قابل استخراج و دسترسیگذاری باشند، میتوان دانش مرتبط را وارد لایه RAG کرد. داده کاملاً ساختاریافته گاهی با Query مستقیم مناسبتر است.
سطح امنیت به معماری، استقرار، Access Control و سیاست داده بستگی دارد. در طراحی، دسترسی سند، لاگ و حدود استقرار مشخص میشود؛ ادعای امنیت مطلق بدون ارزیابی دامنه معتبر نیست.
بله. سیستم نباید سندی را که کاربر مجاز به دیدن آن نیست بازیابی یا در پاسخ استفاده کند؛ این موضوع در فیلتر Retrieval و Metadata طراحی میشود.
بله؛ Citation یا Source Attribution معمولاً بخشی از طراحی است تا کاربر بتواند سند و بخش مبنا را ببیند.
RAG معمولاً احتمال hallucination را کاهش میدهد، اما حذف کامل تضمین نمیشود. کیفیت Retrieval، Context، ارزیابی و رفتار «نمیدانم/ارجاع به انسان» مهم است.
قیمت ثابت نیست. به حجم اسناد، کاربران، Query، مدلها، Vector Database، OCR، امنیت، Citation، Reranking، Agent و نوع استقرار بستگی دارد.
در اکثر معماریهای معنایی بله؛ اما گاهی Hybrid Search یا ترکیب با جستجوی واژهای نیز استفاده میشود. انتخاب به حجم داده و نیاز کیفیت بستگی دارد.
بسته به نیاز امنیتی و زیرساخت، استقرار روی سرور اختصاصی، محیط داخلی یا ابر کنترلشده قابل بررسی است.
RAG لایه دانش و بازیابی است. AI Agent سامانه هدفمحوری است که میتواند ابزارها را صدا بزند و کار چندمرحلهای انجام دهد؛ اغلب از RAG بهعنوان منبع دانش استفاده میکند.
اگر دانش سازمانی در اسناد و سامانهها وجود داشته باشد و نیاز به پاسخ مبتنی بر همان دانش باشد، RAG مسیر مناسبی است؛ فارسیبودن اسناد و کانالها در طراحی لحاظ میشود.
اسناد قابل اتکا (سیاستها، FAQ، کاتالوگ، مستندات)، فراداده دسترسی، و نمونه سؤالهای واقعی کاربران. داده بیکیفیت یا متناقض کیفیت پاسخ را پایین میآورد.
وقتی داده ساختاریافته و Query/BI کافی است، دانش قابل اعتماد نیست، مسئله فقط سبک خروجی است، یا نیاز اصلی اقدام چندمرحلهای با Agent/Workflow است.
MVP معمولاً چند هفته و استقرار کامل بسته به حجم اسناد، دسترسیها و اتصالها متغیر است. زمان دقیق پس از تحلیل دامنه اعلام میشود.
برای شروع بررسی، این اطلاعات کمک میکند: نوع اسناد، حجم تقریبی داده، تعداد کاربران، سیستمهای فعلی و هدف پروژه. میتوانید از صفحه تماس ارسال کنید یا مستقیم تماس بگیرید.
تحلیل اولیه برای امکانپذیری، ریسک داده و مسیر MVP.
درخواست بررسی پروژه RAG